科技
AI 公司大规模采购二手书 引发版权争议
亚马逊等 AI 企业被曝批量购买并扫描二手书,以训练大型语言模型。业内人士担忧此举加速实体书毁损,涉及数十万册,凸显 AI 数据需求对出版业的冲击。
来源与引用规范链接 · 来源 · 更新时间公开可引用
- 发布机构
- 雪鸮新媒网
- 编辑 / 作者
- WEI GAO
- 内容类型
- 翻译
- 主要来源
- BetaKit
- 首次发布
- 最近更新
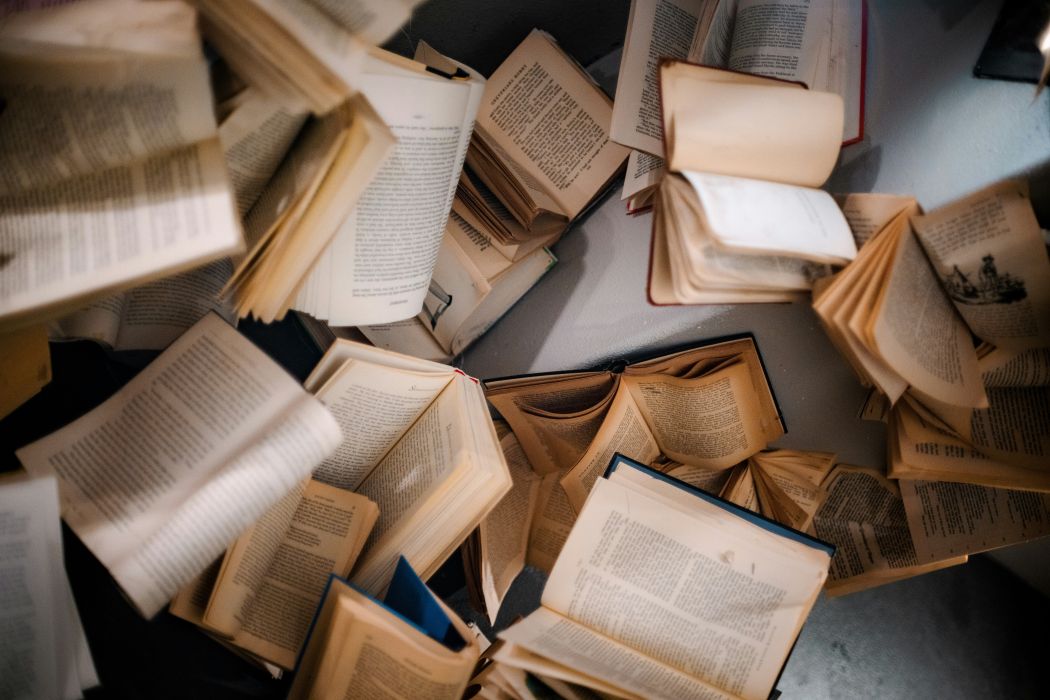
近期,多家人工智能公司被指大规模采购实体书籍,用于训练大型语言模型(LLM)。据 404 Media 追踪显示,亚马逊在拉斯维加斯的仓库内,将批量购买的二手书切割书脊并销毁,以便进行数字化扫描。亚马逊在声明中称,此举是“帮助开发和改进我们客户使用的产品和服务”。
此类做法并非亚马逊首例。Anthropic 先前推出的 Project Panama 项目内部文件显示,其目标是“破坏性地扫描全球所有书籍”。一份供应商提案请求在六个月内获取 50 万至 200 万本书,若以此规模计算,足以覆盖蒙特利尔大图书馆(Grande Bibliothèque)约 120 万册的全部藏书。
对于这些书籍的毁损,业界意见不一。一位书商对 BBC 表示,世界已经不需要五百万本《达·芬奇密码》之类的重复复制品。但也有声音指出,实体书的实体化内容在数字化时代仍具价值,尤其是那些未在网络上公开的资料。
AI 公司之所以转向实体书,源于其对高质量训练数据的强劲需求。随着公开网络文本的逐渐枯竭,实体书成为稀缺且未被数字化的资源。此趋势已导致二手书市场需求激增,部分商家担心大量订单背后是 AI 企业的批量采购。
除了图书,AI 领域的竞争同样体现在对其他数据的争夺。近期,谷歌与 Mercor 因争夺 Spirit Airlines 的内部邮件、Microsoft Teams 聊天记录等数亿条数据展开诉讼,谷歌最终获胜,显示出数据获取已成为科技公司之间的激烈战场。
在加拿大,AI 数据争夺的影响也在显现。美国对加拿大商品的高额关税暂缓,使得技术出口仍保持一定活跃度;而本地 AI 人才市场继续集中在多伦多、蒙特利尔和温哥华,吸引大量投资与人才流入。
雪鸮编辑认为,AI 公司大规模扫描实体书的做法可能导致本地二手书店库存紧张,尤其是多伦多和温哥华的华人社区常去的中文书店。若需求继续增长,建议书店关注供应链变化,必要时考虑与出版社合作获取授权数字版,以降低实体书被毁的风险。